
Le littoral de la voix
Décider ce qui reste dans l’objet et ce qui part au cloud
Depuis plusieurs semaines, nous montons des preuves de concept vocales en vibe coding avec notre agent IA spécialisé en développement. Nous avons intégré Gradium et mesuré la chaîne complète nous-mêmes. Dans les projets, la question qui revient le plus souvent concerne le partage du travail entre l’objet et le cloud, rarement le choix d’un modèle.
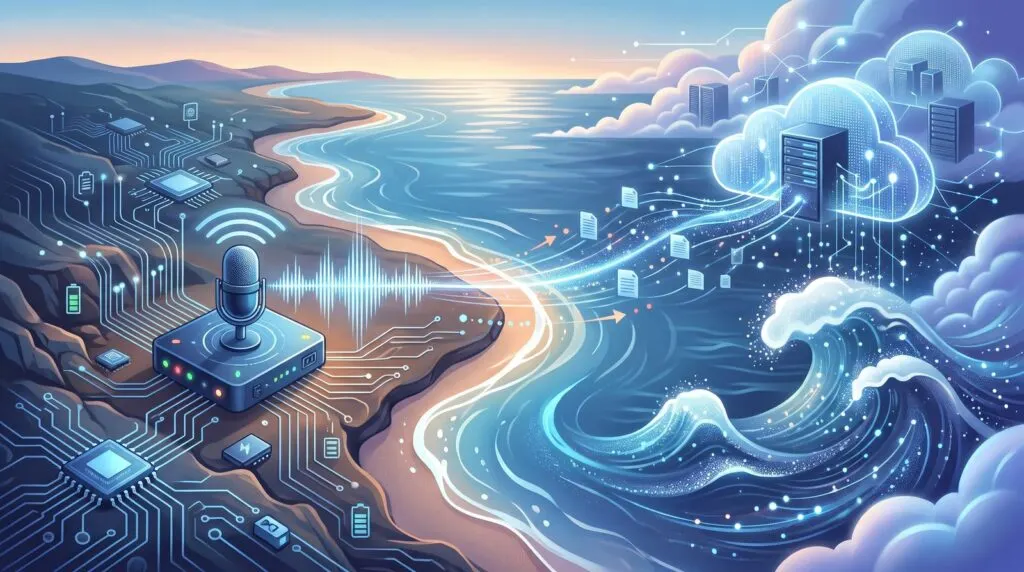
Un produit vocal ressemble à un rivage. D’un côté, l’objet, avec son microphone, son processeur, sa batterie et sa mémoire comptée. De l’autre, le cloud, avec des modèles plus gros, des mises à jour permanentes et une facturation à la requête. Entre les deux, une frontière que l’équipe produit trace elle-même. Les modèles bougent vite ; cette frontière décide de la facture, de l’autonomie et du comportement hors réseau.
Le lexique, sans jargon
| Brique | Rôle | Contrainte de temps | Offre 2026 |
|---|---|---|---|
| Reconnaissance vocale (STT) | Transformer la parole en texte | Flux continu pour l’interactif, traitement différé pour la transcription | Voxtral Realtime, Whisper, Moonshine embarqué |
| Détection de parole et fin de tour | Décider quand la personne a fini de parler | Quelques dizaines de millisecondes | VAD sémantique d’Unmute (Kyutai) |
| Synthèse vocale (TTS) | Transformer le texte en voix | Flux continu pour la conversation | Voxtral TTS, Gradium Phonon |
| Orchestrateur | Relier micro, détection, reconnaissance, modèle de langage et synthèse | Piloter le budget total | Pipecat, LiveKit Agents |
La cascade enchaîne reconnaissance, modèle de langage et synthèse. Chaque brique se remplace séparément, le texte intermédiaire reste disponible pour les journaux et les tests, et l’équipe garde la main sur les consignes. Chaque étage ajoute son délai, et les erreurs se cumulent.
Le bout en bout audio envoie le son au modèle et récupère du son. La conversation gagne en fluidité, l’interruption fonctionne mieux, mais le texte intermédiaire disparaît et le fournisseur contrôle l’ensemble du trajet.
Temps réel et différé ne demandent pas la même chose. Une annonce de fin de cycle ou un compte rendu tolèrent plusieurs secondes. Une conversation exige un budget sous la seconde, mesuré du micro au haut-parleur. Un modèle rapide ne sauve pas une chaîne lente : notre premier tour complet mesurait 2,82 s, dont 249 ms de voix.
Où en sont les briques en 2026
Les chiffres qui suivent sont annoncés par les éditeurs. Les nôtres arrivent plus bas.
Mistral affiche 70 ms pour Voxtral TTS et une transcription sous 500 ms pour Voxtral Realtime, sur plus de 35 langues. Kyutai propose Unmute, une architecture modulaire avec reconnaissance en flux et détection sémantique de fin de tour, et Moshi, un modèle duplex qui écoute et parle en même temps autour de 200 ms.
La vraie nouveauté se joue dans l’embarqué. Gradium, société parisienne, a publié les poids de Phonon le 20 octobre 2026, puis annoncé plus de 200 000 téléchargements en deux semaines. Trois chiffres comptent pour un objet.
- 28 ms avant le premier son pour la variante 31m anglaise, 38 ms pour la 40m, mesurés sur processeur au 95e percentile.
- 64,5 Mo de poids quantifiés en 8 bits pour l’anglais, sous licence Apache 2.0.
- 74,6 Mo pour les variantes 40m en anglais, français, allemand, espagnol et portugais, sous licence non commerciale avec tarification au nombre d’utilisateurs. Le moteur est écrit en Rust, sans PyTorch. Il tourne sur un processeur classique, sans carte graphique, jusqu’à un Raspberry Pi 5, et accélère sur GPU ou NPU quand l’appareil en a un.
Les limites comptent. Le codec n’est pas publié, le tokenizer ne fait que décoder, la normalisation des nombres et des adresses reste à faire, et le découpage en phrases casse la prosodie des textes longs. Un modèle embarqué ne dispense pas du travail d’intégration.
La grille de décision
| Étage | Où le placer | Pourquoi | Compromis |
|---|---|---|---|
| Réveil | Bouton ou mot d’éveil sur le microcontrôleur | L’appui supprime la veille permanente ; le mot d’éveil libère les mains | Friction pour l’appui, fausses détections et consommation pour la veille |
| Détection de parole | Local | Latence et confidentialité | Réglages à trouver dans le bruit réel |
| Reconnaissance de commandes courtes | Local | Fonctionne hors réseau, sans coût par requête | Vocabulaire limité |
| Reconnaissance de dictée longue | Cloud | Qualité et couverture des langues | Coût, réseau, audio qui sort de l’objet |
| Raisonnement | Cloud, avec un petit modèle local pour l’intention | Mémoire et qualité | Dépendance à la connexion |
| Synthèse courte | Local | Premier son rapide et mode hors-ligne | Prosodie plus plate, normalisation à faire |
| Synthèse longue ou expressive | Cloud | Voix naturelle et clonage autorisé | Coût et latence réseau |
| Historique et télémétrie | Cloud | Mises à jour et suivi | Conformité à cadrer |
Le réveil relève du produit plus que de la technique. L’appui supprime la veille permanente, la consommation de fond et la plupart des faux positifs, au prix d’une friction acceptable sur un appareil porté ou manipulé par un technicien. Le mot d’éveil libère les mains, mais impose un classifieur acoustique de quelques mégaoctets et un taux de fausses acceptations à mesurer dans le bruit réel. Alimenté en permanence et utilisé à distance, le mot d’éveil se défend ; sur batterie et pris en main, l’appui suffit.
Pourquoi un objet connecté n’est pas un smartphone
Les sollicitations sont rares : quelques demandes par jour. Le coût cloud d’une requête paraît négligeable. Pourtant chaque interaction doit réussir du premier coup, parce qu’il n’y a pas toujours d’écran pour rattraper une erreur et que la confiance se joue en une tentative.
L’énergie impose sa loi. Une veille micro permanente, un modèle de synthèse local ou un module radio actif pèsent sur l’autonomie. Le partage entre l’objet et le cloud devient une question de consommation, pas seulement de latence.
Le hors-ligne doit être prévu. Un objet qui perd le réseau au mauvais moment doit continuer à fonctionner sur son cœur de métier. Si la connexion tombe au milieu d’un tour, la réponse en cours doit se terminer en local et la conversation reprendre au tour suivant. Garder localement la reconnaissance de quelques commandes et une synthèse courte coûte de la mémoire, et évite de transformer une coupure Wi-Fi en panne produit.
D’autres critères entrent en jeu.
- La taille du modèle.
- Le coût de certification et de mise à jour du firmware.
- La capacité de l’équipe à régler les seuils de détection.
Ces points figurent rarement dans les comparatifs de modèles, alors qu’ils décident du prix de revient.
Les leçons de nos essais
Nous avons mesuré, nous n’avons pas comparé des fiches techniques.

Sur serveur, le modèle Phonon 40m en français sort le premier son en 161 à 240 ms et synthétise près de treize secondes de parole en moins de deux secondes. Dans le téléphone, le même modèle démarre entre 92 et 240 ms, sans réseau et sans quota. Un tour complet de conversation tient alors en 2,82 s, dont 249 ms de voix ; avant optimisation, le même tour prenait 14,4 s, et le modèle n’était pas le goulot.
Côté cloud, une phrase de 68 caractères demande environ 1,5 s à la synthèse pour rendre 4,16 s d’audio, et 3,7 s à la reconnaissance pour la retranscrire. Sur une phrase courte, l’embarqué gagne un ordre de grandeur sur le premier son, et le cloud garde la main sur l’expressivité et la couverture des langues. Le chiffre constructeur de 38 ms décrit le modèle ; nos 161 à 240 ms décrivent la chaîne jusqu’au premier échantillon audible. Les deux sont vrais, ils ne parlent pas de la même chose.
L’embarqué a un prix qu’aucun comparatif n’affiche : environ 75 Mo de plus dans une application qui pèse 93,6 Mo. Trois pièges d’intégration nous ont coûté plus de temps que le choix du modèle.
- Un identifiant de voix inconnu rend un fichier vide, sans erreur remontée.
- Un WAV aux tailles non renseignées annonce une durée absurde.
- Rien ne borne la longueur d’un texte confié au moteur.
Le modèle se choisit en une semaine, l’intégration décide du produit.
Cinq mesures décident d’une architecture.
- La latence au 50e et au 95e percentile, du micro au premier son.
- Le taux d’erreur dans le bruit du produit.
- Le coût par minute côté cloud.
- La consommation en veille et en conversation.
- La taille mémoire.
Sans ces chiffres, un comparatif de modèles ne dit rien du produit.
Décider tôt
La voix embarquée change la nature de l’objet sans remplacer l’écran : un appareil qui comprend, répond et se tait quand il faut, y compris sans réseau.
La décision structurante se prend tôt, et elle appartient à l’équipe produit. Elle sépare l’usage qui exige le cloud de celui qui doit tenir dans l’objet, et elle dit ce qui se passe quand le rivage est coupé. Le modèle choisi changera deux fois pendant la vie du produit. La frontière, elle, restera.
Sources :
Speaking of Voxtral, Mistral AI
Voxtral 3 : Speech-to-Text, TTS & Voice Agents, Mistral AI
Unmute: Make LLMs listen and speak, Kyutai
The best open source frameworks for realtime voice and video AI agents, LiveKit
À lire aussi
Checkpoints EVT/DVT/PVT : 3 pièges qui tuent un Hardware avant la série
Un prototype qui fonctionne n’est pas un produit. Entre les deux, il y a trois jalons qui ne se sautent pas : EVT, DVT, PVT. Ce ne sont pas des cases à…
Lire la suite
Le budget fantôme : NRE, outillage, tests, ce qui vous rattrape en fin de projet
Un projet peut être « dans le budget » pendant des mois, puis basculer en trois semaines. Le produit est validé, la série est lancée, et une facture arrive …
Lire la suite
Roadmap industrielle : comprendre EVT, DVT, PVT sans jargon
EVT, DVT, PVT, pré-série, série : ces étapes ne sont pas du jargon industriel. Elles structurent la transformation d’une idée en produit fiable, certifiable…
Lire la suiteUn projet Hardware ou IoT en vue ?
Bénéficiez de notre expertise industrielle pour auditer votre maturité, optimiser votre BOM ou réussir votre passage à l'échelle.